
Architektura i przepływ danych
Architektura opiera się na dwóch zasadach: ujednoliceniu rozwiązania u różnych dostawców infrastruktury oraz inicjowaniu połączeń wychodzących przez Edmunda.
Architektura zgodna z Azure i Amazon Web Services
Edmund stosuje spójną architekturę w Azure, AWS i instalacjach On-premise. Konteneryzacja, na przykład Docker, i orkiestracja, na przykład Kubernetes, ujednolicają wdrażanie, zarządzanie i utrzymanie. Umożliwiają przenoszenie, skalowanie i niezawodne działanie platformy niezależnie od infrastruktury.
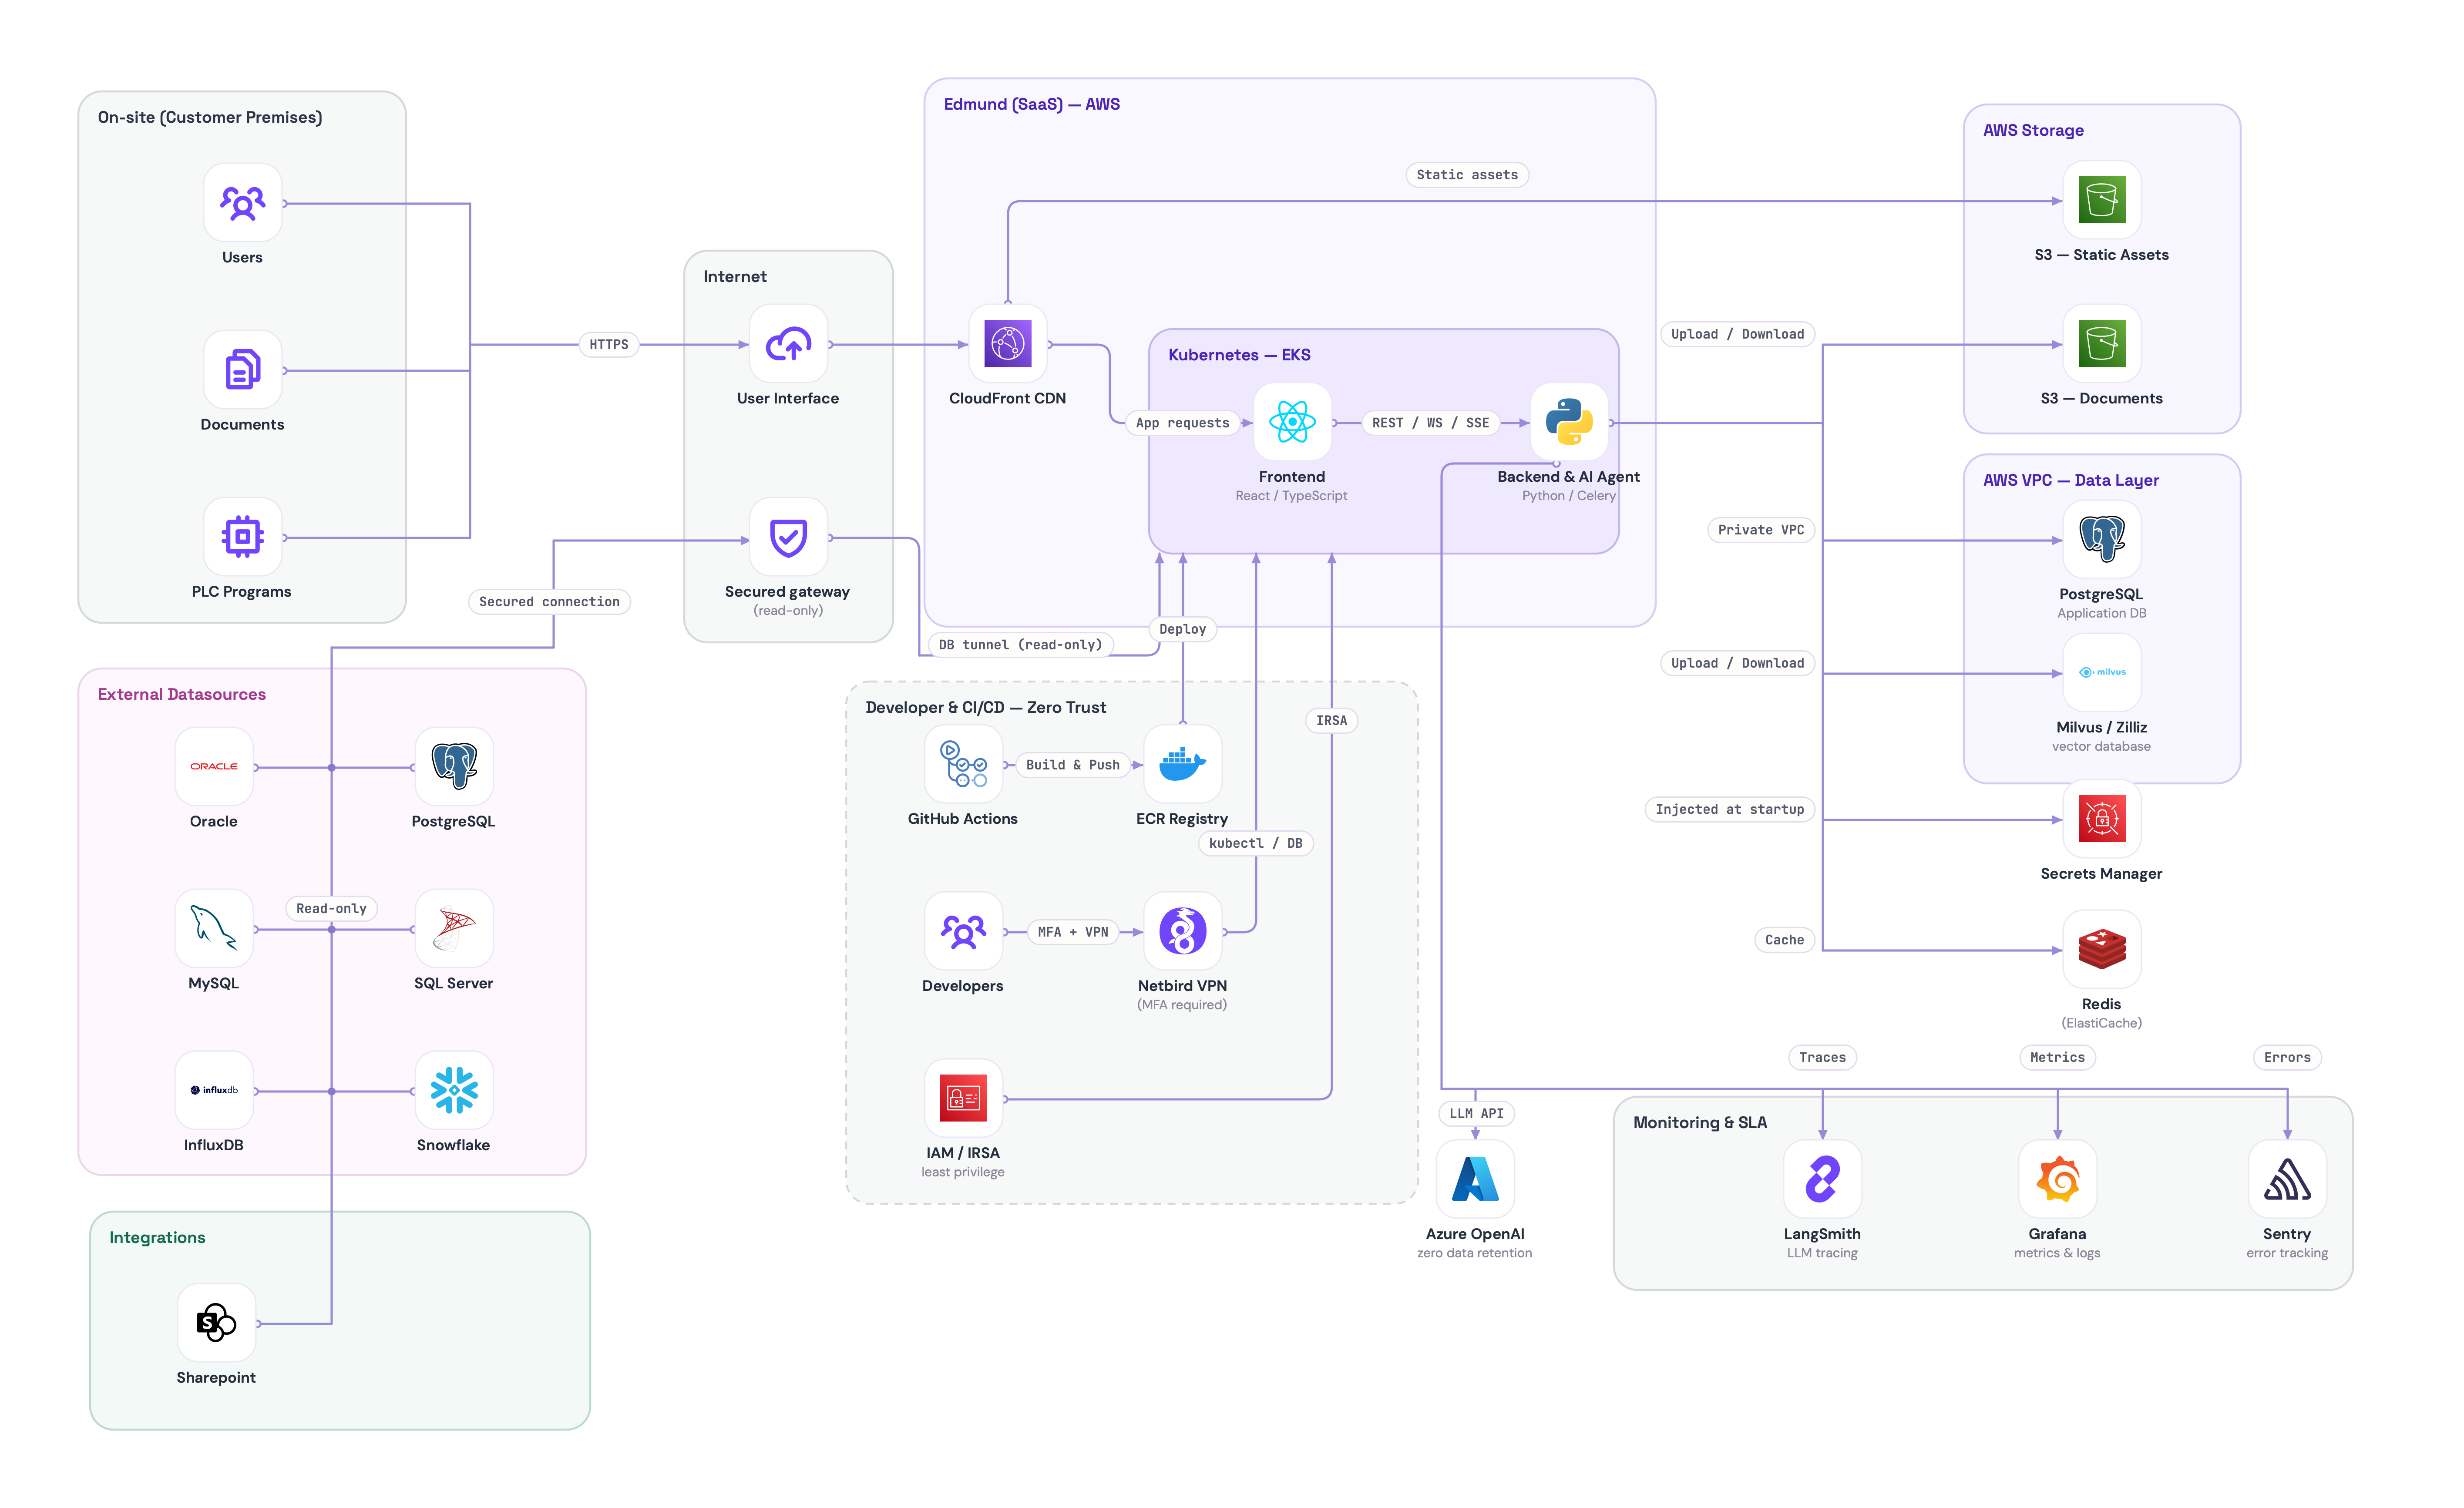
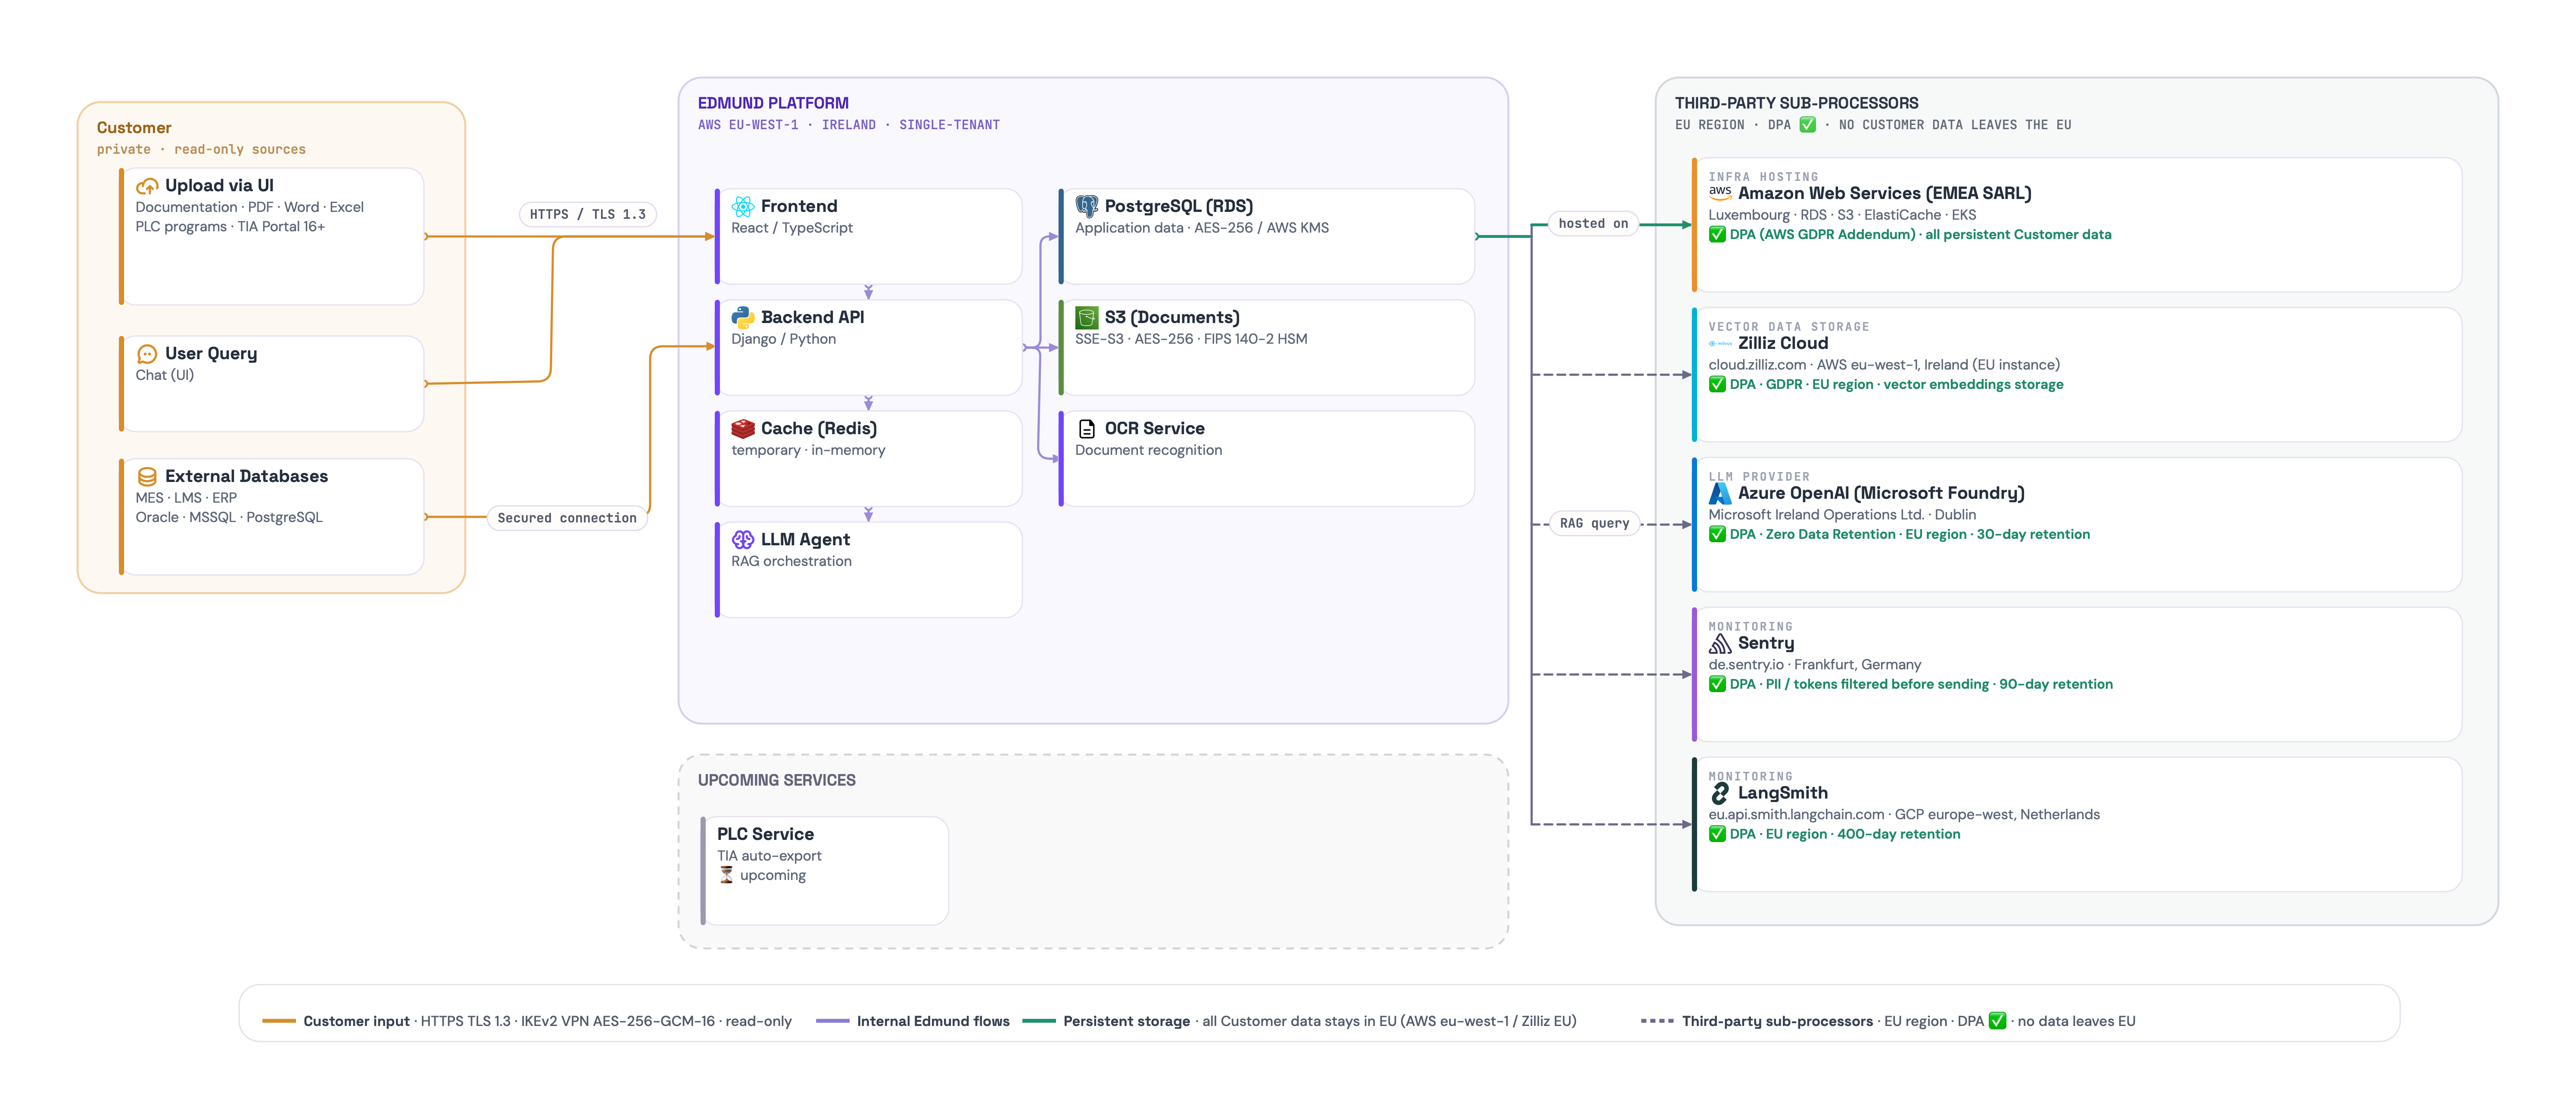
Poniżej znajdują się przegląd architektury i schemat przepływu danych. Opis komponentów następuje po schematach.
Architektura chmurowa AWS
Schemat przepływu danych
Główne komponenty
- Frontend: aplikacja TypeScript w React, komunikująca się z REST API.
- Backend API: Python i Django.
- Baza danych: jedna instancja PostgreSQL na dane aplikacyjne oraz Milvus Zilliz, utrzymywany lokalnie lub w chmurze, do indeksowania dokumentów. W instalacjach On-premise baza Milvus może działać lokalnie.
- Pamięć podręczna: Redis.
- Usługi i procesy indeksujące: przetwarzanie dokumentów i źródeł danych.
- Agent LLM: integracja z Azure OpenAI API.
- Orkiestracja: Kubernetes w AWS, Azure, GCP lub On-premise.
- Monitoring i logi: Sentry do aplikacji, LangSmith do LLM oraz Grafana do metryk systemowych.
- Uwierzytelnianie: obsługiwane MFA lub SSO.
Dane są przetwarzane tymczasowo i nie są trwale zapisywane poza bazą klienta. Szczegóły dotyczące danych telemetrycznych, śladów LLM i wyników analitycznych opisuje rozdział Klasyfikacja i retencja danych.
Opis komponentów
Podstawa platformy: stale działający zestaw procesów obsługujących interfejs i API, jeden proces przyjmujący i przetwarzający dokumenty, pula sześciu równoległych agentów czatu oraz baza stanu aplikacji. Ten minimalny zestaw występuje w każdym wdrożeniu.
Skalowalne jednostki:
- Proces indeksujący: zwiększa przepustowość dla większych zbiorów dokumentów. Jeden proces obsługuje około 30 000 stron dziennie lub około 10 standardowych programów PLC dziennie. Dodatkowe procesy pomagają przy rosnącej kolejce importu lub jednoczesnym uruchamianiu wielu fabryk.
- Agenci czatu: zwiększają liczbę jednoczesnych użytkowników. Każdy dodatkowy blok dodaje sześciu równoległych agentów. Bloki można dodawać dla szczytowego obciążenia.
- Monitoring: mała instancja do śledzenia błędów i obserwowania wywołań modeli. Kolejne jednostki zapewniają oddzielny monitoring lub większą pojemność.
Usługi rozliczane według użycia:
- Usługa OCR: zamienia skany i dokumenty obrazowe na tekst odczytywany maszynowo.
- Milvus, baza wektorowa: przechowuje embeddingi i obsługuje wyszukiwanie semantyczne. Może działać lokalnie lub w chmurze. Rozliczenie zależy od liczby embeddingów, zaokrąglonej do kolejnego zapewnionego poziomu zasobów.
Poziomy wdrożenia: orientacyjna skala i użycie
| Parametr | Poziom 1 | Poziom 2 | Poziom 3 |
|---|---|---|---|
| Docelowa skala | 1–5 fabryk | 5–10 fabryk | 30–40 fabryk |
| Procesy indeksujące | 1 | 3: podstawowy i 2 dodatkowe | 7: podstawowy i 6 dodatkowych |
| Równolegli agenci czatu | 6 | 12: dodatkowy 1 blok | 24: dodatkowe 3 bloki |
| Instancje monitoringu | 1 | 2 | 5 |
| Konwersje OCR | 20 000 stron/miesiąc | 100 000 stron/miesiąc | 500 000 stron/miesiąc |
| Embeddingi Milvus | 5 mln, około 3 CU i 60 GB S3 | 20 mln, około 10 CU i 240 GB S3 | 100 mln, około 50 CU i 1200 GB S3 |
| Wiadomości czatu | 800–4000/miesiąc | 4000–8000/miesiąc | 24 000–32 000/miesiąc |
Połączenia
Materiały odczytywane przez Edmunda trafiają przez poniższe połączenia. Każde jest szyfrowane przez HTTPS/SSL, uwierzytelniane tokenem API lub kontem technicznym i ograniczone do potrzebnego zakresu.
Źródła danych
Edmund odczytuje bazę klienta przez konto tylko do odczytu. Dokumentacja techniczna obejmuje Oracle, PostgreSQL, Microsoft SQL Server, SAP HANA, Snowflake i InfluxDB. Dostępność konkretnego konektora w interfejsie zależy od udostępnionych funkcji danego środowiska.
Każde połączenie wykorzystuje jednego użytkownika i jeden schemat. Wymagania poszczególnych silników opisuje Specyfika poszczególnych baz danych. Połączenie w AWS, przez NAT Gateway z przekierowaniem portów lub Site-to-Site VPN opisuje Połączenie ze źródłami danych klienta.
Integracje
- Konektor SharePoint: synchronizuje dokumenty tylko do odczytu z jednej witryny SharePoint. Foldery monitorowanej biblioteki odpowiadają projektom Edmunda. Plik dodany do folderu pojawia się w projekcie bez ręcznego przesyłania. Edmund nigdy nie zapisuje w SharePoint. Instrukcja Working with SharePoint obejmuje rejestrację aplikacji, przyznanie dostępu do witryny i bieżącą obsługę.
- API: opcjonalne połączenie z wewnętrznym REST lub GraphQL API klienta.
Akceptowane formaty i limity rozmiarów zawiera rozdział Obsługiwane formaty plików.