
Architektura a tok dat
Naše architektura se drží dvou hlavních pravidel: jednotnost napříč poskytovateli serverů a výhradně odchozí provoz z Edmunda.
Architektura kompatibilní s Azure a Amazon Web Services
Architektura Edmunda se konzistentně uplatňuje ve všech nasazovacích prostředích, tedy v Azure, AWS i on-premise. Jednotné struktury je dosaženo použitím kontejnerizace (Docker) a orchestrace (Kubernetes), což zjednodušuje nasazení, správu i údržbu v různých provozních kontextech.
Tyto technologie zajišťují přenositelnost, škálovatelnost a spolehlivost platformy Edmund bez ohledu na infrastrukturu, na které běží.
Níže je přehled architektury a diagram toku dat; popis komponent následuje za diagramy.
Cloudová architektura (AWS)
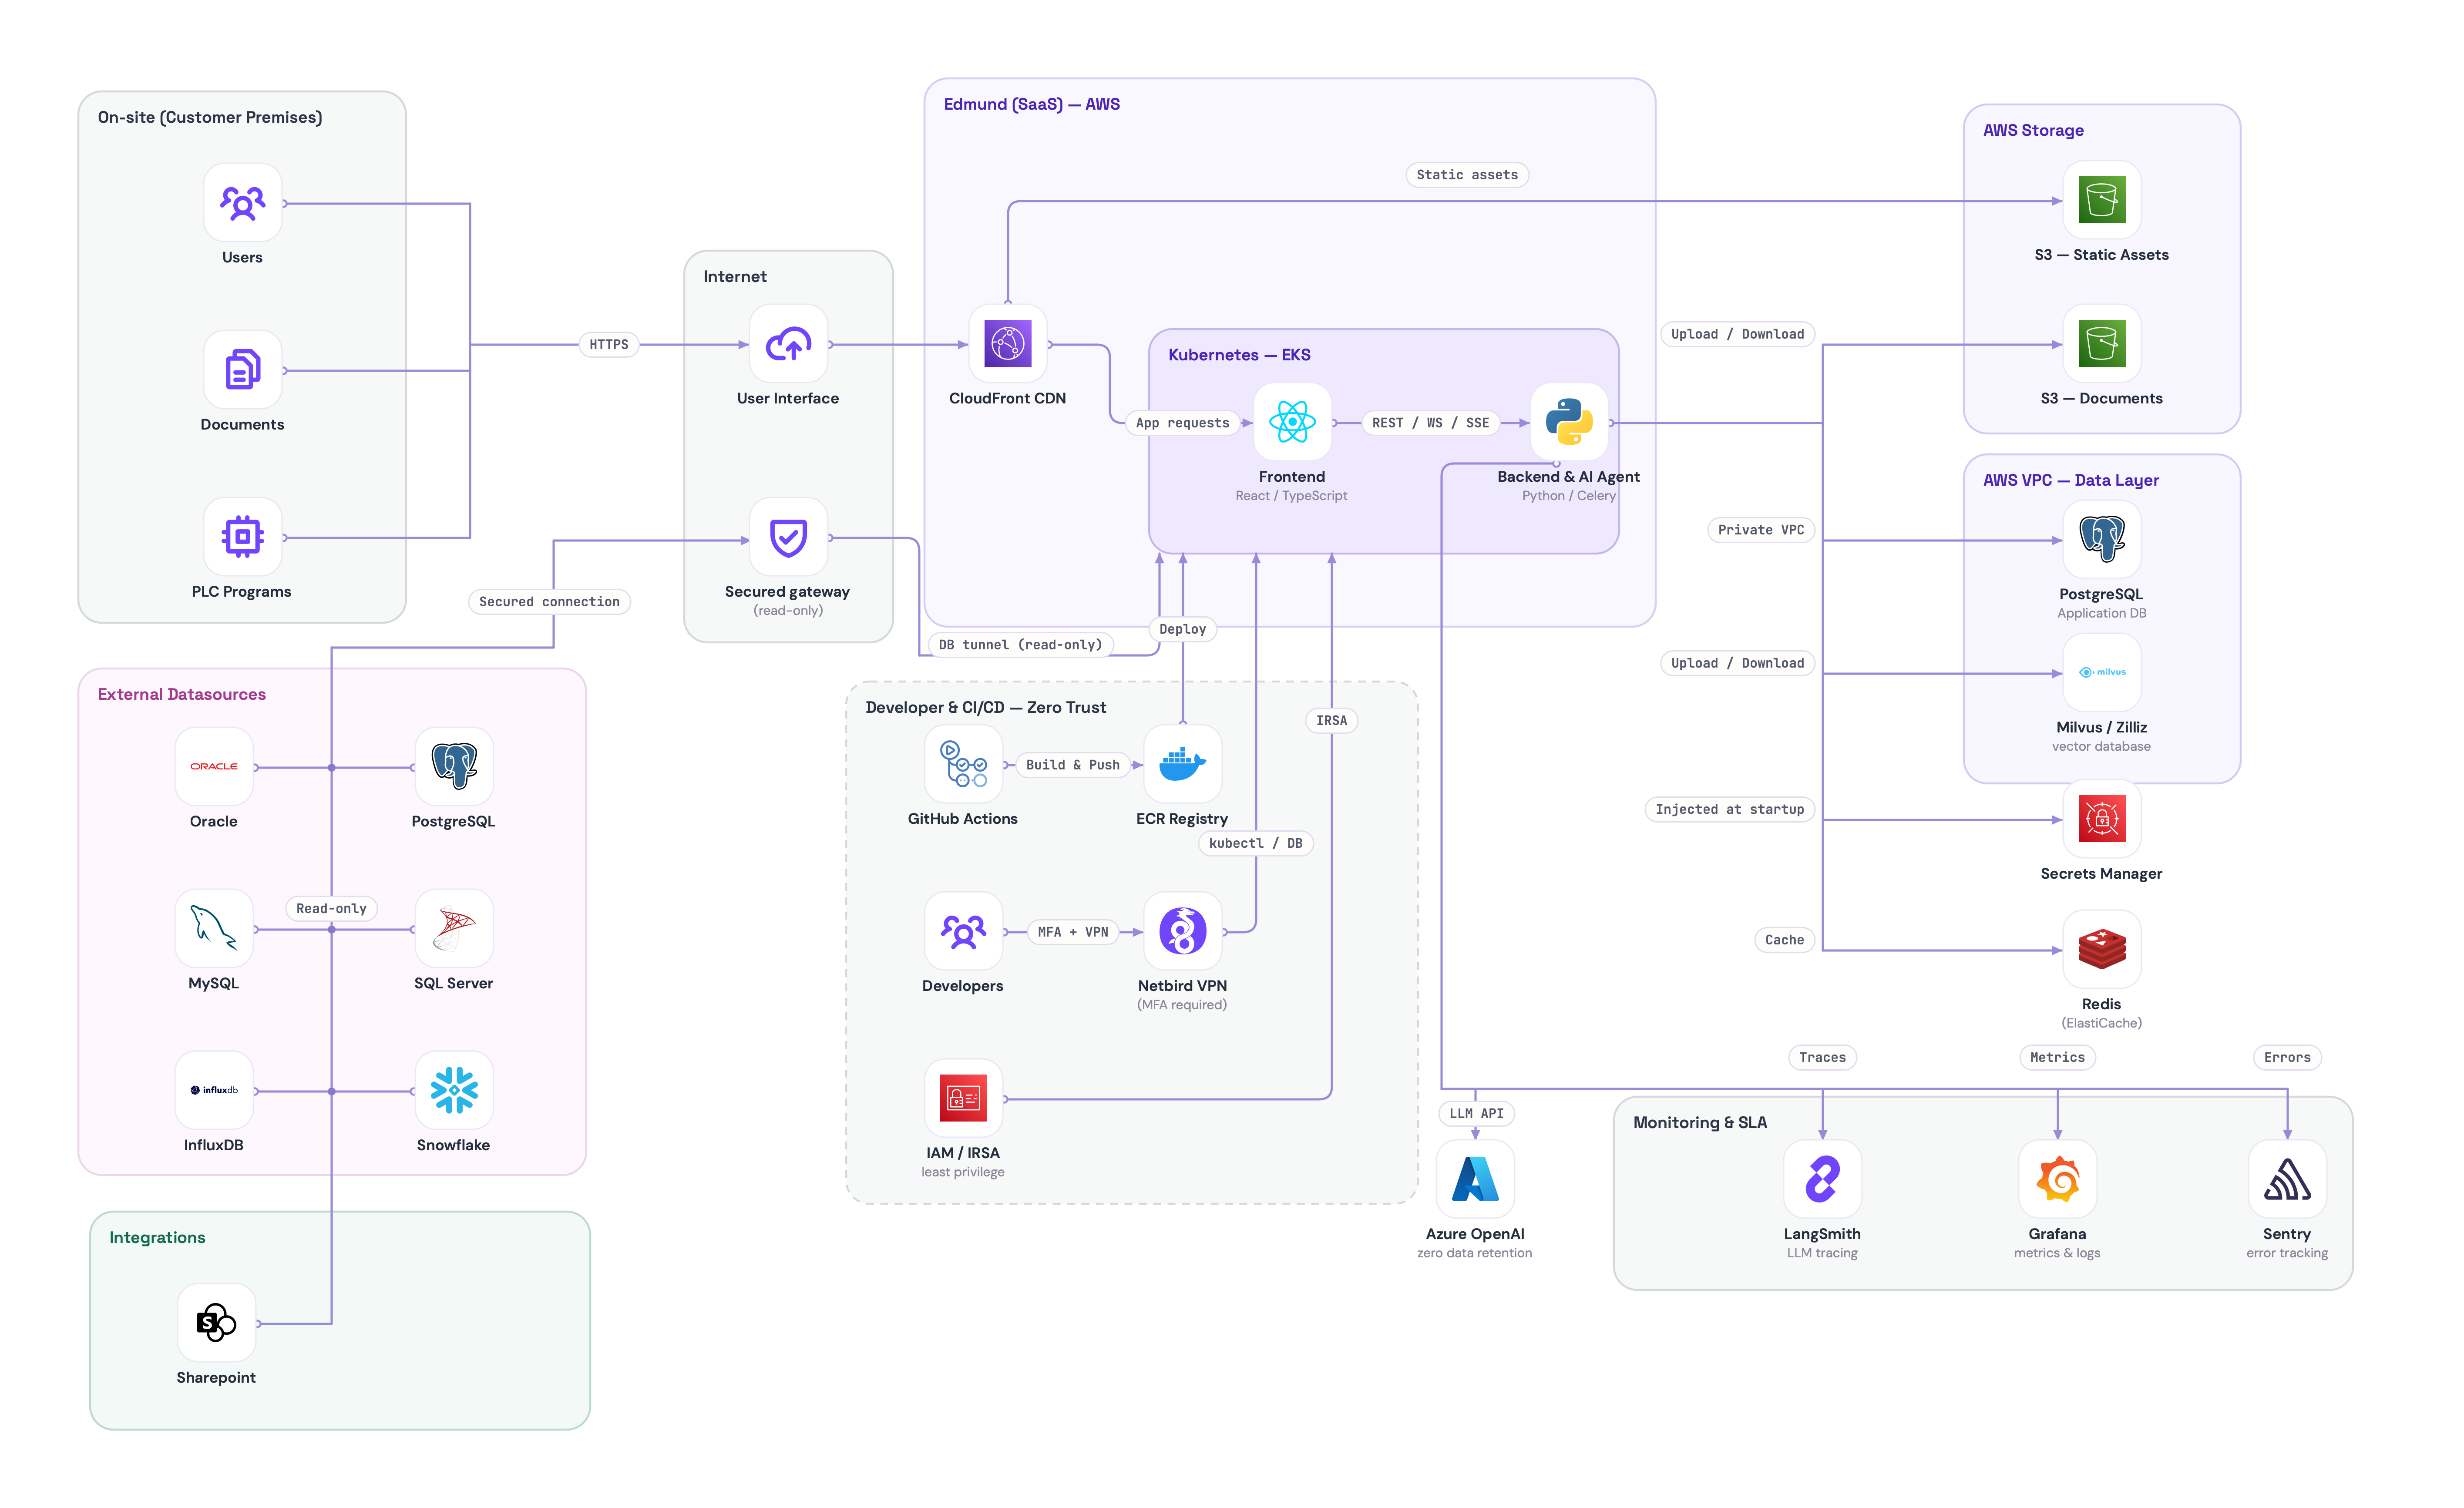
Diagram toku dat
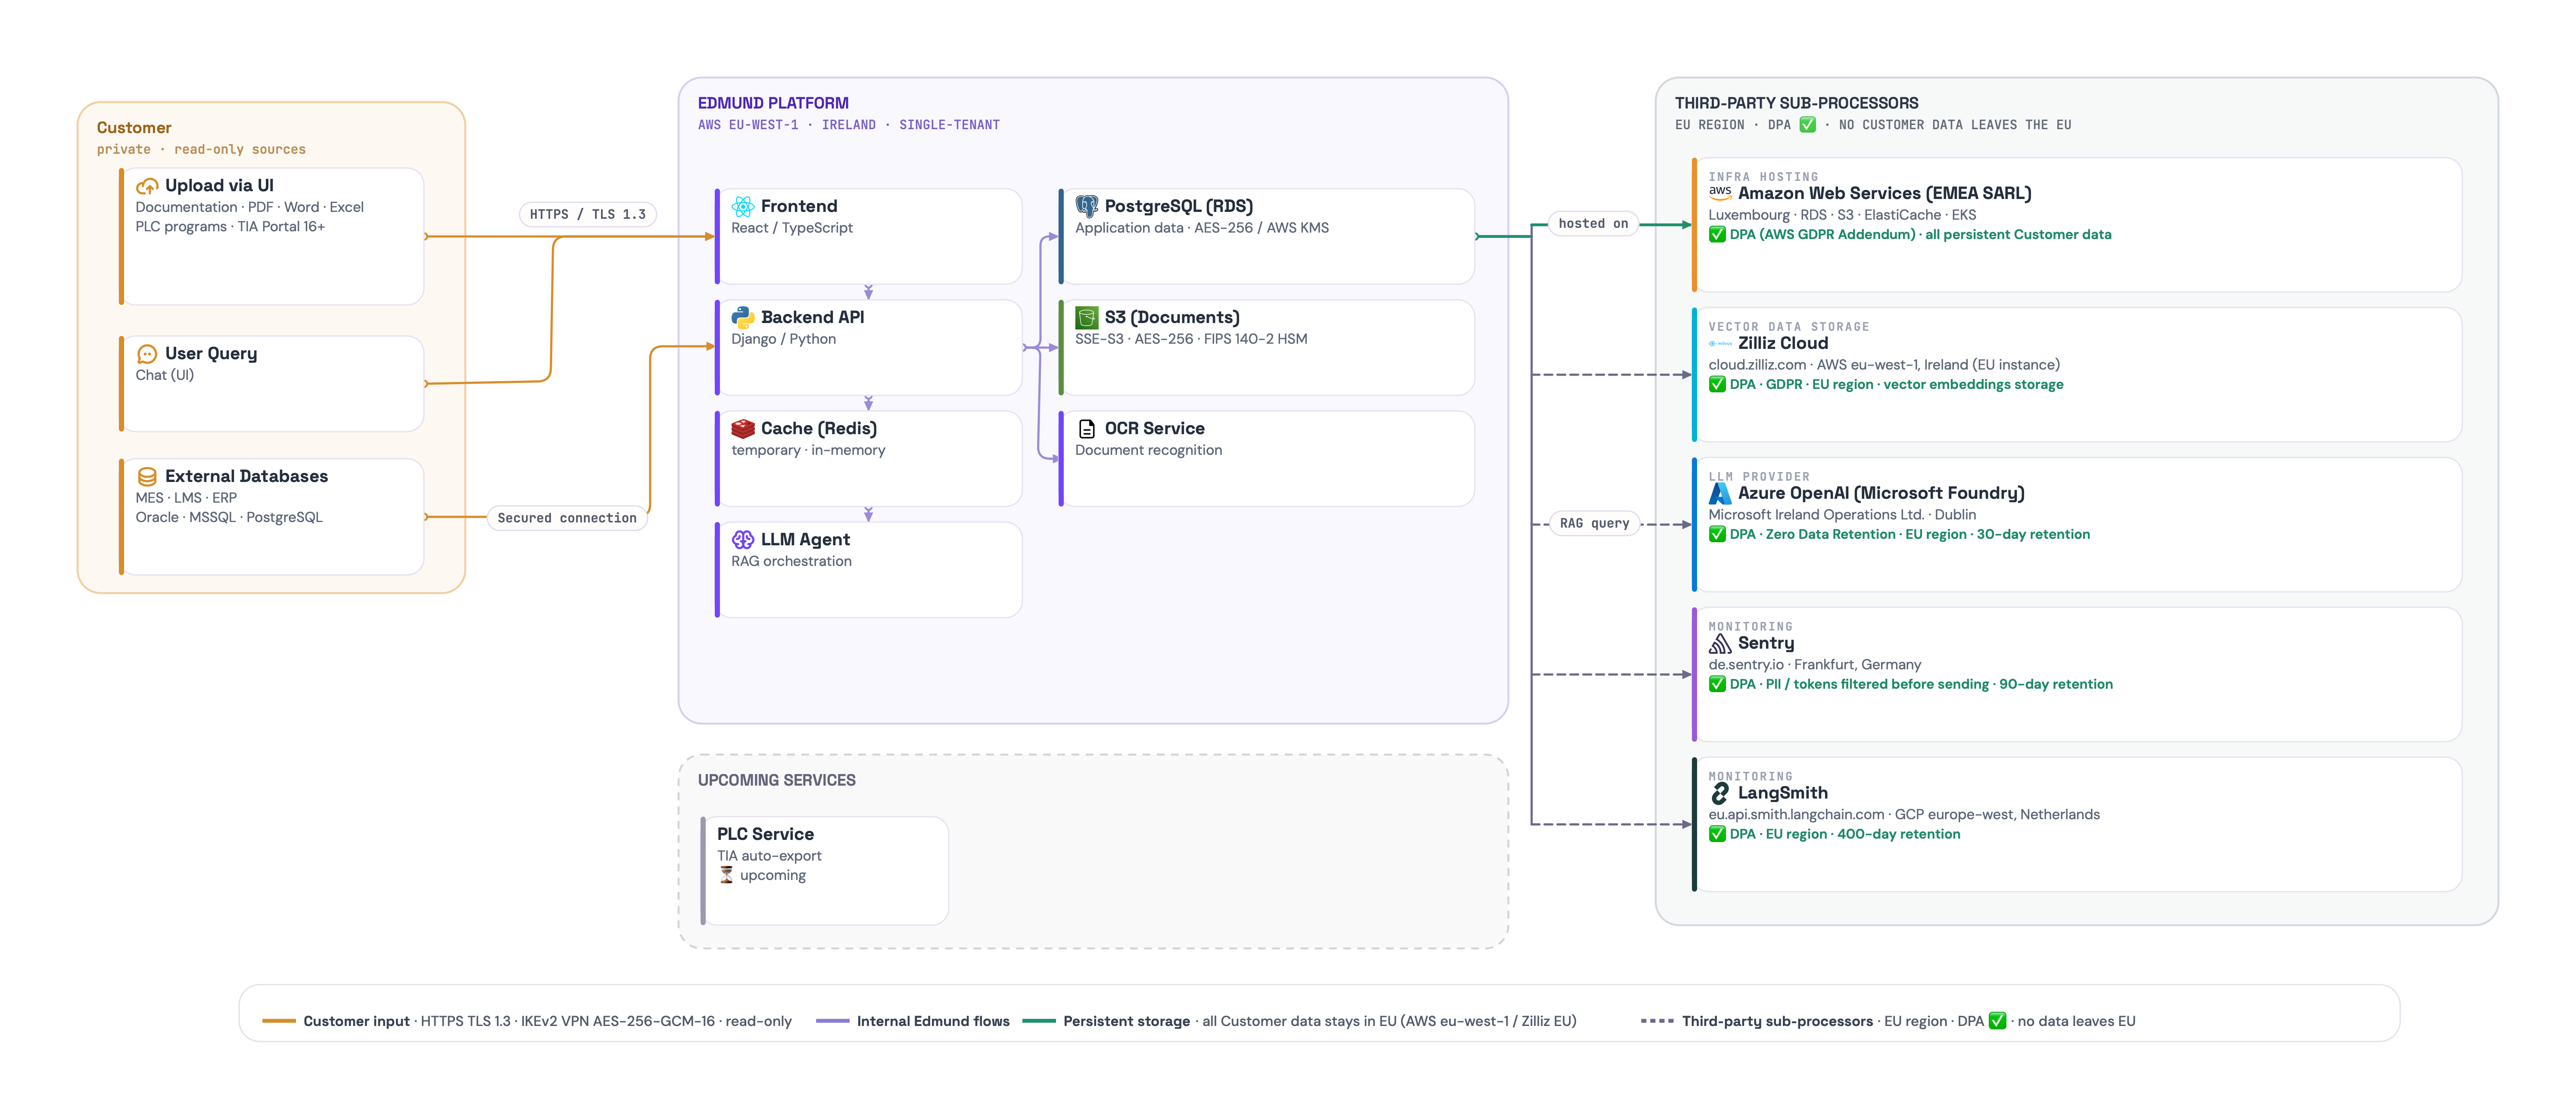
Hlavní komponenty architektury
Frontend: aplikace v TypeScriptu (framework React) komunikující s REST API
Backend API: Python (framework Django)
Databáze: jedna instance PostgreSQL pro data aplikace a Milvus Zilliz (self-hosted nebo cloud-hosted databáze) pro indexaci dokumentů. U on-premise instalací může být databáze Milvus hostovaná lokálně.
Cache: Redis
Indexovací služby a workery: zpracování dokumentů a datových zdrojů
LLM agent: integrace s Azure OpenAI API
Orchestrace: Kubernetes (nasaditelný v AWS, Azure, GCP nebo on-premise)
Monitoring a logování:
-
Sentry (monitoring aplikace)
-
LangSmith (monitoring LLM)
-
Grafana (systémové metriky)
Autentizace: podporované připojení přes MFA nebo SSO
Veškerá data se zpracovávají dočasně a neukládají se trvale mimo databázi zákazníka.
Popis komponent
Základ
Base platform — trvale běžící základ Edmunda. Zahrnuje web workery, které obsluhují uživatelské rozhraní a API, jeden indexovací worker, který přijímá a zpracovává dokumenty, pool 6 souběžných chat agentů odpovídajících na dotazy uživatelů a backendovou databázi se stavem aplikace. Je to minimum potřebné k provozu Edmunda a je součástí každého nasazení.
Škálovatelné jednotky
Indexing worker — přidává kapacitu na zpracování dokumentů pro větší objemy. Jeden worker zvládne přibližně 30 000 stran denně nebo asi 10 standardních PLC programů denně. Workery přidávejte, když roste nezpracovaná fronta nebo když se současně onboarduje více závodů.
Chat agents — zvyšuje počet uživatelů, kteří mohou s Edmundem pracovat současně. Každý blok přidává 6 souběžných chat agentů; bloky přidávejte, když se ve špičce očekává více souběžných konverzací.
Monitoring — malá monitorovací instance pokrývající sledování chyb a observabilitu volání modelů. Další jednotky poskytují oddělené nebo kapacitně větší pokrytí, jak nasazení roste.
Služby účtované podle spotřeby
Custom OCR service — převádí skenované a obrázkové dokumenty do strojově čitelného textu.
Milvus (vektorová DB) — self-hosted nebo cloud-hosted vektorová databáze, která ukládá embeddingy a zajišťuje sémantické hledání a vyhledávání kontextu. Účtuje se podle počtu uložených embeddingů, zaokrouhleno nahoru na další alokovanou úroveň (viz tabulka níže).
Úrovně nasazení (indikativní dimenzování a očekávané využití)
| Dimenze | Tier 1 | Tier 2 | Tier 3 |
|---|---|---|---|
| Cílový rozsah | 1–5 závodů | 5–10 závodů | 30–40 závodů |
| Konfigurace | |||
| Indexovací workery | 1 | 3 (base + 2 navíc) | 7 (base + 6 navíc) |
| Souběžní chat agenti | 6 | 12 (+1 blok) | 24 (+3 bloky) |
| Monitorovací instance | 1× | 2× | 5× |
| Očekávané využití | |||
| OCR konverze | 20 000 stran/měs. | 100 000 stran/měs. | 500 000 stran/měs. |
| Embeddingy v Milvusu | 5 M (≈ 3 CU, ≈ 60 GB S3) | 20 M (≈ 10 CU, ≈ 240 GB S3) | 100 M (≈ 50 CU, ≈ 1 200 GB S3) |
| Zprávy v chatu | 800–4 000/měs. | 4 000–8 000/měs. | 24 000–32 000/měs. |
Připojení
Všechno, co Edmund čte, přichází jedním z níže uvedených připojení. Každé z nich je šifrované (HTTPS / SSL), autentizované (API token nebo servisní účet) a omezené na nezbytný rozsah.
Datové zdroje
Edmund čte zákaznickou databázi přes účet pouze pro čtení. Podporované databáze:
- Oracle
- PostgreSQL
- Microsoft SQL Server
- SAP HANA
- Snowflake
- InfluxDB
Na jedno připojení jeden uživatel a jedno schéma; co která databáze potřebuje, řeší kapitola Specifika jednotlivých databází. Jak se samotné připojení zřizuje — v rámci AWS, přes NAT gateway s port forwardingem, nebo Site-to-Site VPN — řeší kapitola Připojení k datovým zdrojům zákazníka.
Integrace
- SharePoint konektor – synchronizace dokumentů z jedné SharePointové site, pouze pro čtení. Složky ve sledované knihovně dokumentů se mapují na projekty v Edmundovi, takže soubor vložený do složky se objeví v odpovídajícím projektu, aniž by ho někdo nahrával ručně. Edmund do SharePointu nikdy nezapisuje. Registraci aplikace, udělení přístupu k site i každodenní provoz popisuje návod Práce se SharePointem.
- API – volitelné připojení k internímu REST nebo GraphQL API zákazníka.
Jaké formáty souborů která cesta přijímá a jaké platí limity velikosti, uvádí kapitola Podporované formáty souborů.